タグ: 生成AI

  • Google、法務向け「Gemini Enterprise for Legal」発表 AIは“職業別”へ

    Google、法務向け「Gemini Enterprise for Legal」発表 AIは“職業別”へ

    Google Cloudは8月25日、法律事務所や企業の法務部門向けAIソリューション「Gemini Enterprise for Legal」を発表した。

    一般向けのGeminiとは異なり、契約書の確認や法務リサーチ、規制変更の監視など、法律業務に特化したAI機能をGemini Enterprise上で提供する。

    単独のアプリではなく、企業向けAI基盤「Gemini Enterprise」に追加する法務向けプラグインとして提供される。現在はプレビュー段階となっている。 (Google Cloud⁠)

    契約書の確認から規制調査までAIが支援

    Gemini Enterprise for Legalには、法律業務向けに設計されたAIスキルやAIエージェントが用意されている。

    主な用途には、

    • 契約書の確認や修正文案の作成
    • 社内ルールに沿った契約チェック
    • 法律・規制変更の監視
    • 法務リサーチ
    • 個人情報開示請求への対応
    • 訴訟関連業務

    などが含まれる。

    例えば契約書では、企業が設定したルールと照らし合わせてリスクの高い条項を検出し、修正案を提示したうえで承認フローへ回すことも可能だ。 (Google Cloud⁠)

    「一般的なAI」だけでは法律業務には足りない

    法律業務では、AIの性能だけでなく情報の正確性や機密性が重要になる。

    Googleは、一般的な生成AIだけでは法律業務に求められる条件を十分に満たせないとしている。

    法律事務所では、案件ごとに閲覧できる情報が異なり、顧客の機密情報や社内独自のルールも扱う。

    Gemini Enterprise for Legalでは、既存システムのアクセス権限を引き継ぎ、AIもその利用者が本来閲覧できる情報だけにアクセスする仕組みを採用している。 (Google Cloud⁠)

    AIの回答には確認できる情報源を表示

    生成AIを法律業務で使ううえで大きな問題となるのが、誤った情報や存在しない判例などをAIが生成する「ハルシネーション」だ。

    Gemini Enterprise for Legalでは、企業内部の文書や許可された法律データベースをもとに回答を生成し、元となった情報を確認できる引用元も表示する。

    法律家がAIの回答をそのまま信用するのではなく、根拠まで確認できる設計となっている。 (Google Cloud⁠)

    企業データはGoogleのAI学習には使用しない

    法務では顧客情報や企業秘密など、特に機密性の高い情報を扱う。

    Googleによると、Gemini Enterprise for Legalで扱われる顧客データ、企業独自のルール、知的財産、AIへの指示や出力内容などは組織内に保持され、Googleの基盤AIモデルの学習や追加学習には使用されない。

    AI導入の利便性だけでなく、企業がAIへどこまで情報を渡せるのかという課題にも対応した形だ。 (Google Cloud⁠)

    大手法律事務所も開発に参加

    Googleは、Cleary Gottlieb、Freshfields、Weil、Williams & Connollyなど世界的な法律事務所と協力しながらサービスを開発している。

    Reutersによると、Thomson Reuters、Harvey、Legoraなど法律分野のAI・情報サービスとも接続できる仕組みを整えている。

    法律業界ではすでに生成AIをリサーチ、文書作成、案件管理などへ取り入れる動きが進んでおり、Googleも本格的にこの市場へ参入する形となる。 (Reuters⁠)

    法律だけではなく金融、医療にも

    今回Googleが発表したのは、法務向けAIだけではない。

    金融機関向けの「Gemini Enterprise for Financial Services」も発表されており、金融業界向けのデータや業務プロセスに対応したAIエージェントを提供する。

    Googleは今後、ヘルスケア、ライフサイエンスなどにも業界特化型Geminiを広げる方針だ。 (Google Cloud⁠)

    AI LinkHub解説

    今回のニュースで注目したいのは、Geminiに法律の知識が追加されたことだけではありません。

    AIの進化が、

    「何でも質問できる汎用AI」
    → 「特定の仕事を実際に進める業界専用AI」

    へ進んでいることです。

    法律、金融、医療などの専門職では、単にAIが高性能であるだけでは使えません。

    正確性、情報源、アクセス権限、機密情報の管理、業界独自のルールなどを守ったうえで、実際の仕事の流れに組み込む必要があります。

    Gemini Enterprise for Legalは、AIモデル単体ではなく、専門知識・企業データ・AIエージェント・セキュリティをセットにすることで、そこへ対応しようとしています。

    ただし、これは「AIが弁護士の代わりになる」という意味ではありません。

    契約内容の判断や法的な戦略、最終的な責任など、人間の専門家による判断が重要であることは変わりません。

    今後は「どのAIが一番賢いか」だけでなく、それぞれの職業でAIをどう安全に組み込めるかが、企業向けAI競争の大きなポイントになりそうです。

    情報元

    • Google Cloud:Gemini Enterprise for Legal公式発表
    • Google Cloud:Gemini Enterprise for Legal製品情報
    • Reuters:Googleの法律業界向けGemini展開に関する報道
  • Meta、「AI前提」の大規模組織再編を縮小 AIエージェント、期待した生産性に届かず

    Meta、「AI前提」の大規模組織再編を縮小 AIエージェント、期待した生産性に届かず

    Metaが、AIを前提に組織を大きく作り替える計画を進めていたものの、一部を縮小していたことが分かった。

    Reutersが8月26日に報じた調査報道によると、Metaは2026年初め、「Project OT(Organization Transformation)」と呼ばれる組織再編計画を始動。AIエージェントに日常業務の多くを任せ、人間はより少人数のチームで業務を進める「AI-native」な組織を構想していた。

    内部のシナリオでは、一部のチームについて最大60%規模を縮小する案も検討されていたという。

    ただし、これはMeta全社員の60%を解雇する計画ではない。MetaもReutersに対し、最大60%という数字は一部チームを対象としたシナリオであり、配置転換や空きポジションの削減なども含まれていたと説明している。 (Reuters)

    少人数の「AIネイティブ」チームを構想

    Metaが目指していたのは、従来の組織にAIを追加するだけではなく、仕事の進め方そのものをAI前提に作り直すことだった。

    従来10〜20人程度で構成されていたプロダクト開発チームを、AIを活用する3〜5人程度の小規模な「Pod」に変更。

    エンジニアやデザイナーなどの役割を細かく分けるのではなく、AIを使いながら複数の仕事をこなす「Builder」を中心とした組織を想定していた。

    2026年6月までに、少なくとも11の部門でこうした小規模チームが導入されていたという。 (Reuters)

    AIで作れる量は増えたが、生産性は比例せず

    しかし、AI導入によって「作業量」が増えても、それがそのまま企業全体の生産性向上につながるとは限らなかった。

    Reutersが確認したMetaの内部資料によると、社内システムなどに対するコード変更件数は前年同期比で220%増加した一方、実際に利用者へ届けられた新機能や改善につながる変更は36%増にとどまった。

    さらに、AIエージェントによる大量の処理がシステムへ影響し、重大な技術・セキュリティ関連のインシデントが前年より40%増え、問題対応に費やす時間も70%増えたとする内部データもあった。

    Metaは、こうしたAIによる混乱に関する内部データについてReutersへのコメントを控えている。 (Reuters)

    2回目の大規模再編を中止

    Project OTでは、5月と11月の2段階で組織再編を進める計画だった。

    Metaは5月20日に約10%の人員削減を実施したものの、その直前に11月に予定していた2回目の大規模再編の計画を中止した。

    背景には、社員からの強い反発や士気の低下に加え、AIエージェントが期待していたほど生産性を向上させていないという社内データがあったとReutersは報じている。

    7月にはMark Zuckerberg氏自身も社内集会で、AIエージェント技術の進展が想定したほど速くなかったとの認識を示したという。 (Reuters)

    Metaは「人を置き換える」から「人を強化する」方向へ

    一方、MetaがAI活用そのものを後退させたわけではない。

    Zuckerberg氏は8月に公表したAIの将来像で、AIの最大の価値は単純な自動化ではなく、人々の能力を拡張し、新しいものを生み出せるようにすることだとの考えを示している。

    企業の人数は将来的に小さくなる可能性がある一方、それが社会全体の仕事の減少を意味するとは限らないとの見方も示した。 (Facebook)

    AI LinkHub解説

    今回の事例で重要なのは、「AIが役に立たなかった」という話ではないことです。

    MetaではAIによってコードを作る量そのものは大きく増えています。しかし、「作れる量が増えること」と「会社全体の成果が増えること」は別でした。

    AIが大量に仕事を処理できても、

    ● 出力内容を確認する

    ● 問題が起きたときに修正する

    ● どの仕事をAIに任せるか判断する

    ● 最終的な品質に責任を持つ

    といった役割は依然として人間側に残ります。

    今回のMetaの事例は、現在のAIが「人間を丸ごと置き換える道具」というより、人間の仕事を強化する道具として使った方が成果につながりやすい段階にあることを示す一例と言えそうです。

    特に企業がAIを導入するときは、「何人減らせるか」から考えるのではなく、どの仕事をAIに任せれば、人間がより重要な仕事へ時間を使えるかという視点の方が重要なのかもしれません。

    情報元

    ● Reuters:Metaの「Project OT」に関する調査報道

    ● Meta:Mark Zuckerberg氏「The Future is for Everyone」

  • Claudeの「メモリ」が進化 チャットとCoworkで記憶を共有、内容の確認・編集も可能に

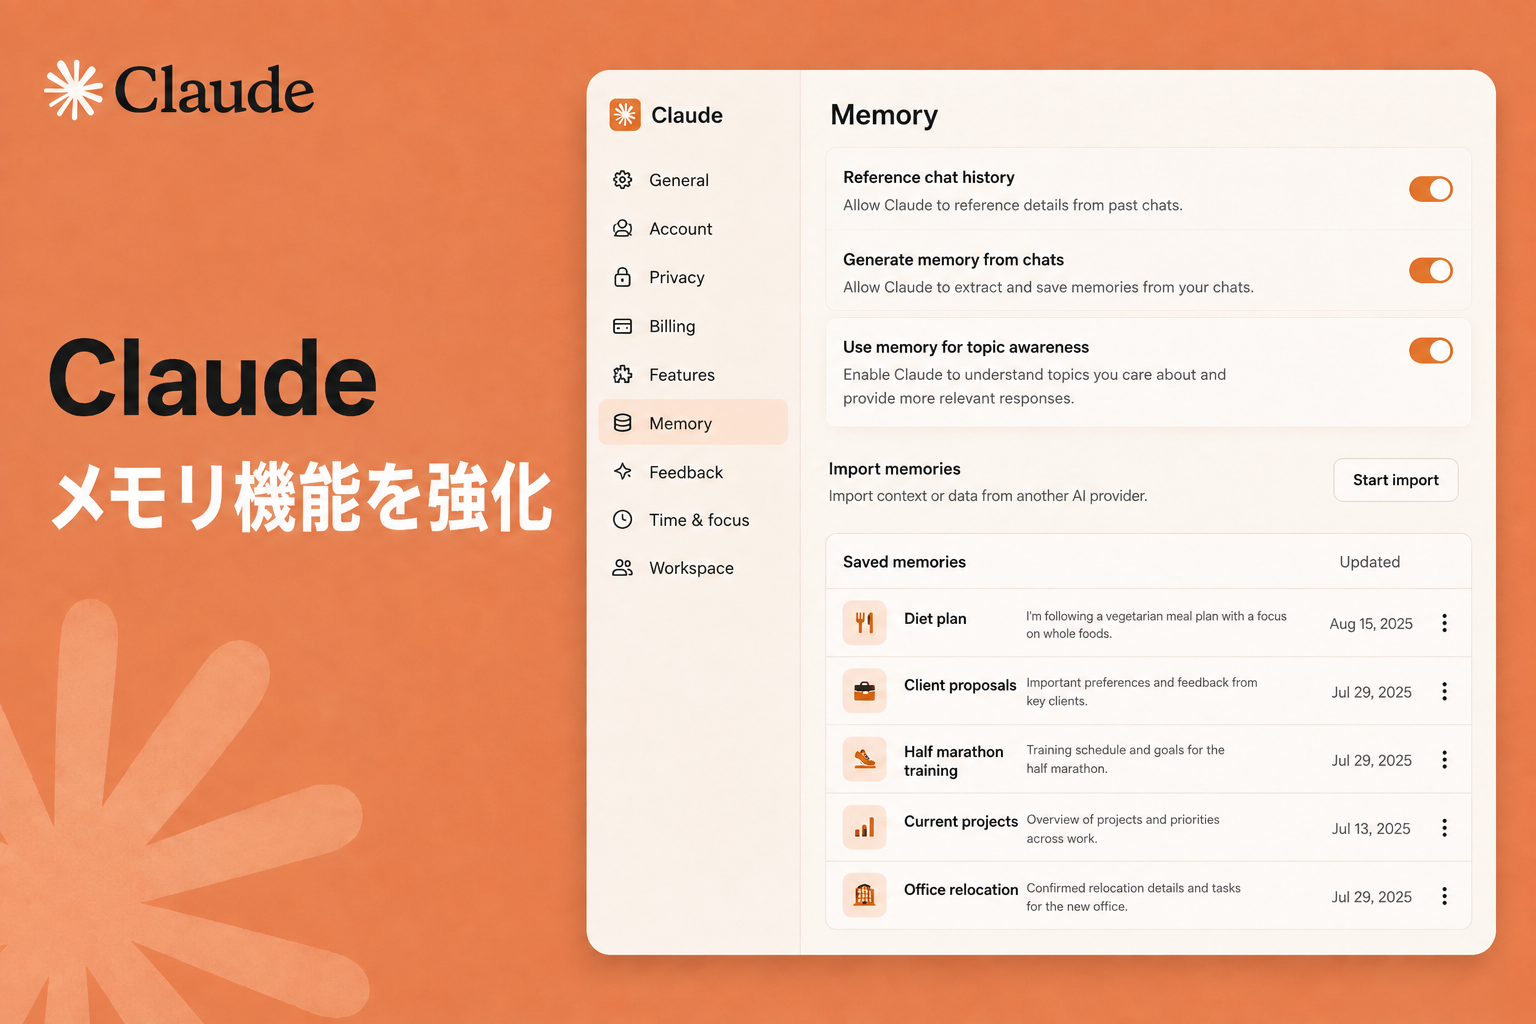
    Claudeの「メモリ」が進化 チャットとCoworkで記憶を共有、内容の確認・編集も可能に

    Anthropicは8月25日、AIアシスタント「Claude」のメモリ機能をアップデートした。

    通常のClaudeチャットと、複数ステップの作業を実行する「Claude Cowork」で同じメモリを共有するようになり、一度伝えた情報を別の機能でも引き継げるようになった。

    さらに、Claudeが何を記憶しているのかを利用者自身が確認し、編集や削除もできる。

    AIが利用者の情報を継続的に覚える一方、その記憶をユーザー側で管理できる仕組みが強化された形だ。 (Claude⁠)

    チャットで伝えた情報をCoworkでも利用

    今回のアップデートでは、通常のチャットとClaude Coworkのメモリが統合された。

    例えばチャットで、

    • 現在進めているプロジェクト
    • 締め切りや優先順位
    • チーム内で使う用語
    • 資料の書き方

    などを伝えておけば、Coworkで別の作業を依頼するときにも、その前提を引き継げる。

    逆に、Coworkで新しく分かった情報も、次回以降のClaudeチャットで利用される。

    これまで機能を切り替えるたびに同じ背景情報を説明していた場合、その手間を減らせるようになる。 (Cornerstone of Hope⁠)

    会話中にメモリを更新

    メモリを保存する仕組みも変更された。

    従来は会話終了後に内容を整理して記憶する方式だったが、新しいClaudeでは会話中にメモリへ情報を追加する。

    例えば、プロジェクトの締め切りが9月へ変更されたことを会話中に伝えれば、その情報がメモリへ反映され、次回の会話から新しい締め切りを前提として利用できる。

    毎回「これを覚えておいて」と指示する必要も減る。 (Cornerstone of Hope⁠)

    Claudeが覚えている内容を自分で確認できる

    今回のアップデートで重要なのが、記憶されている情報の透明性だ。

    Claudeの「Settings → Memory」には、記憶されている内容が「Topics」として整理される。

    利用者はそれぞれの内容を確認し、

    読む・編集する・削除する

    ことが可能だ。

    例えば会社名が変更された場合、保存された情報を直接修正すれば、以降の会話でも新しい名称が利用される。

    メモリ機能自体を一時停止したり、リセットしたりすることもできる。 (Cornerstone of Hope⁠)

    センシティブな情報は原則保存しない

    一方、健康、宗教、政治的信条、人種・民族、ジェンダーアイデンティティなどのセンシティブな情報は、初期設定ではメモリに保存されない。

    利用者が必要と判断した場合には、設定からセンシティブな情報を記憶する機能を有効にできる。

    ただし、政府発行の個人識別番号など、一部の情報については設定を変更しても記憶されないとしている。

    センシティブ情報を保存する設定は初期状態ではオフとなっている。 (Cornerstone of Hope⁠)

    Freeプランでも利用可能

    新しいメモリ機能は、Web、デスクトップ、モバイルのFree、Pro、Maxプランで利用できる。

    これらの個人向けプランではメモリが初期状態で有効になっており、必要に応じて設定から変更できる。

    TeamとEnterpriseでは、組織の管理者がメモリ機能を利用可能にするかを管理し、個々の利用者が自分で有効にする仕組みとなる。 (Cornerstone of Hope⁠)

    AI LinkHub解説

    今回のアップデートで特に重要なのは、単に「Claudeがたくさん覚えるようになった」ということではありません。

    AIが覚えている情報を、利用者自身が確認して修正できるようになったことです。

    AIのメモリは便利ですが、間違った情報を覚えたまま使われると、その後の回答にも影響する可能性があります。

    そのため、

    覚える → 確認できる → 修正できる → 消せる

    という仕組みは、AIを長期間使ううえで非常に重要です。

    また、チャットとCoworkでメモリが共通化されたことで、Claudeは「質問するたびに一から説明するAI」から、継続的な仕事やプロジェクトを支援するAIへさらに近づいたと言えます。

    今後AIエージェントが複数の作業を代行するようになれば、AIがどれだけ高性能かだけでなく、「これまでの経緯をどこまで正確に引き継げるか」も使いやすさを左右する重要な要素になりそうです。

    一方で、AIに何を覚えさせるのかは利用者側でも意識する必要があります。

    便利だからすべて保存するのではなく、設定画面で一度メモリの内容を確認し、「覚えてほしい情報」と「残したくない情報」を自分で管理する使い方が重要です。

    情報元

    Anthropic:Claude’s memory works everywhere, and you decide what’s in it

  • OpenAI、13〜17歳向け「ChatGPT for Teens」開始 宿題の丸投げ抑制や保護者機能を搭載

    OpenAI、13〜17歳向け「ChatGPT for Teens」開始 宿題の丸投げ抑制や保護者機能を搭載

    OpenAIは8月18日、13〜17歳の利用者向けに「ChatGPT for Teens」の提供を開始した。

    通常のChatGPTを大幅に制限した別サービスではなく、学習やアイデア整理など従来の機能を利用しながら、10代向けの安全対策や学習支援機能を追加した専用環境となる。

    利用者が13〜17歳と申告した場合だけでなく、OpenAIのシステムが18歳未満と推定した場合にも、自動的にChatGPT for Teensが適用される。

    対象となるアカウントには順次展開されており、Freeを含む個人向けプランで利用できる。

    「答えを教えるAI」から「考えるのを助けるAI」へ

    ChatGPT for Teensで特に重視されているのが学習支援だ。

    搭載されるStudy Modeでは、問題の答えをすぐに提示するのではなく、質問やヒント、段階的な説明を通じて利用者自身が答えへたどり着けるよう支援する。

    さらに、宿題をそのままAIに解かせようとしていると判断した場合には、Study Modeを使った段階的な学習を促す「宿題リマインダー」も導入される。

    小テストや理解度確認などの機能も用意され、単に課題を終わらせるためではなく、内容を理解するためのAI利用を促す設計となっている。

    長時間利用やAIへの依存にも対策

    学習以外の使い方にも、10代向けの仕組みが追加された。

    長時間利用している場合には休憩を促すリマインダーを表示するほか、ChatGPTが人間ではなくAIであることを明確に伝える案内も強化する。

    また、18歳未満の利用者に対しては、AIが恋愛的な表現を使ったり、感情的な依存を促したり、自身に感情や意識があるかのように振る舞ったりすることを抑える。

    自傷、暴力、摂食障害などのセンシティブな話題についても、通常より強い保護機能が適用される。

    OpenAIは、AIだけで問題を抱え込ませるのではなく、必要に応じて家族や専門家など現実世界の支援につなげることを重視している。

    保護者向け機能も用意

    保護者は、自身のアカウントと10代の利用者のアカウントを連携できる。

    連携すると、ChatGPTを利用できない時間帯を設定する「Quiet Hours」や、一定時間は新しい会話をStudy Modeから開始させる「Study Hours」などを設定できる。

    ただし、保護者が子どものChatGPTでの会話内容を自由に読むことはできない。

    安全上の重大な懸念が検知された場合には保護者へ通知される場合があるものの、その際も必要な情報に限定されるとしている。

    年齢をAI側でも推定

    ChatGPT for Teensでは、利用者が入力した年齢だけに頼らない点も特徴となる。

    OpenAIは年齢予測システムを導入しており、アカウント情報などから利用者が18歳未満と判断された場合、自動的に10代向けの環境へ切り替える。

    18歳以上の利用者が誤って対象となった場合には、年齢確認によって通常のChatGPTへ戻すこともできる。

    AIが幅広い年代に利用されるようになるなか、すべての利用者に同じAI体験を提供するのではなく、年齢に応じてAIの振る舞いや機能を変える動きが本格化してきた。

    AI LinkHub解説

    今回のポイントは、OpenAIが「10代にはAIを使わせない」という方向ではなく、年齢に合わせてAIの使い方そのものを設計する方向へ進んだことです。

    特に興味深いのが、宿題への対応です。

    生成AIが普及してから、「AIを使うと自分で考えなくなるのではないか」という問題は教育現場でも議論されてきました。

    ChatGPT for Teensでは、答えを出す能力を単純に弱くするのではなく、Study Modeや宿題リマインダーを使って「AIと一緒に考える」方向へ誘導しています。

    これは、AI教育において重要な変化だと考えられます。

    AIを完全に禁止すれば、AIを使う能力そのものを学ぶ機会も失われます。一方、何でもAIに任せてしまえば、自分で考える機会が減る可能性があります。

    その中間にある、

    「AIを使いながら、自分でも考える」

    という使い方をどう作るか。

    ChatGPT for Teensは、その一つの答えを示そうとしているサービスと言えそうです。

    また、保護者が会話内容を自由に読めない設計になっている点も重要です。

    安全性を高めながら、10代の利用者のプライバシーも残す必要があり、AIサービスが年齢ごとの利用環境をどう設計するかという課題は今後さらに重要になりそうです。

    情報元

    • OpenAI:ChatGPT for Teens公式発表
    • OpenAI Help Center:ChatGPT for Teensの機能・提供状況
    • Reuters:ChatGPT for Teensの提供開始と安全機能に関する報道
  • Alibabaの小型AI「Qwen3.8-27B」、大型モデル級の性能 AI競争は“効率化”へ

    Alibabaの小型AI「Qwen3.8-27B」、大型モデル級の性能 AI競争は“効率化”へ

    中国Alibabaが公開したAIモデル「Qwen3.8-27B」が、モデル規模を抑えながら大型AIモデルに迫る性能を示している。

    Qwen3.8-27Bは、270億(27B)パラメータを持つオープンウェイトのAIモデル。テキストだけでなく、画像や動画の入力にも対応するマルチモーダルモデルだ。

    AI性能を独自に評価するArtificial Analysisでは、Qwen3.8-27Bが「Intelligence Index」で52を記録。OpenAIのGPT-5.6 Lunaと同水準となり、はるかに規模の大きい中国DeepSeekやZhipu AIのモデルにも迫る結果となった。(南華早報 (https://urldefense.com/v3/__https://www.scmp.com/tech/tech-trends/article/3364404/alibabas-lightweight-qwen-model-takes-larger-ai-systems-openai-deepseek-zhipu?utm_source=chatgpt.com__;!!J2iG0cdYQnxMGEh0ZjhLAT9Vcpc!Yc1G5A770oiZ1qGG0HI2wX4WVpUzBRzQp4Jx3LYRIQV3xXexTG1WzJh_oO5up0mSlHeEONNkagpEDTy4I2TAs0iEiF6yO331Tvg$ ))

    270億パラメータで大型モデルに迫る

    AIモデルでは一般的に、パラメータ数を増やし、より多くの計算資源を使うことで性能を高める開発が進められてきた。

    一方、Qwen3.8-27Bの特徴は、その規模の小ささにある。

    Alibabaによると、Qwen3.8-27Bは同社の大型モデル「Qwen3.7-Plus」と比較して大幅に小さいモデルでありながら、コーディング、専門的な業務、研究、AIエージェントを使った長時間のタスクなどで高い性能を発揮するという。

    Alibabaは、Qwen3.7-Plusの約10分の1の規模ながら同等水準の性能を実現したとしている。(AlibabaCloud (https://urldefense.com/v3/__https://www.alibabacloud.com/blog/603463?utm_source=chatgpt.com__;!!J2iG0cdYQnxMGEh0ZjhLAT9Vcpc!Yc1G5A770oiZ1qGG0HI2wX4WVpUzBRzQp4Jx3LYRIQV3xXexTG1WzJh_oO5up0mSlHeEONNkagpEDTy4I2TAs0iEiF6yC4IyMmE$ ))

    第三者評価でも高い性能が確認されており、Artificial AnalysisのIntelligence Indexでは52を記録。オープンウェイトモデルの中でも上位に位置している。(Artificial Analysis (https://urldefense.com/v3/__https://artificialanalysis.ai/models/qwen3-8-27b?utm_source=chatgpt.com__;!!J2iG0cdYQnxMGEh0ZjhLAT9Vcpc!Yc1G5A770oiZ1qGG0HI2wX4WVpUzBRzQp4Jx3LYRIQV3xXexTG1WzJh_oO5up0mSlHeEONNkagpEDTy4I2TAs0iEiF6yF9eOeZI$ ))

    ただし、ベンチマークはAI性能の一側面を測るものであり、すべての用途で大型モデルと同じ性能を発揮することを意味するわけではない。

    一般的なハードウェアでも動かしやすく

    モデルが小さくなるメリットは、性能だけではない。

    巨大なAIモデルを動かすには、大量のGPUやメモリーを備えたデータセンターが必要になる場合が多い。

    これに対しAlibabaは、Qwen3.8-27Bについて一般消費者向けのハードウェアでも動作させることが可能で、モデルを圧縮する「量子化」を利用すればノートPCでも実行できるとしている。(AlibabaCloud (https://urldefense.com/v3/__https://www.alibabacloud.com/blog/603463?utm_source=chatgpt.com__;!!J2iG0cdYQnxMGEh0ZjhLAT9Vcpc!Yc1G5A770oiZ1qGG0HI2wX4WVpUzBRzQp4Jx3LYRIQV3xXexTG1WzJh_oO5up0mSlHeEONNkagpEDTy4I2TAs0iEiF6yC4IyMmE$ ))

    また、Qwen3.8-27Bはモデルの重みが公開されている「オープンウェイト」のモデルだ。

    企業や開発者が自社環境に導入したり、用途に合わせて活用したりしやすく、AIを必ずクラウド上の巨大なデータセンターで動かす必要がない選択肢にもつながる。

    「大きなAIを作る競争」だけではなくなる

    AI業界では、より大きなモデルを作るために巨額の設備投資が続いている。

    Microsoft、Google、Meta、Oracleなどは大規模なAIデータセンターを建設し、NVIDIA製GPUや大量のメモリーを確保するため、多額の資金を投じている。

    一方で、中国企業を中心に「より少ない計算資源で高い性能を出す」方向の競争も進み始めている。

    2025年にDeepSeekが低コストなAIモデルで世界的な注目を集めたのも、その象徴の一つだった。

    Qwen3.8-27Bのような小型モデルの性能向上が続けば、今後のAI競争では、

    「どれだけ巨大なAIを作れるか」だけでなく、「どれだけ効率よく高性能なAIを動かせるか」

    という視点が、さらに重要になる可能性がある。

    AI LinkHub解説

    今回のニュースは、前回取り上げた「AIサーバーのコスト上昇」と対照的な動きです。

    AIの性能を高めるために巨大なデータセンターへ投資する一方で、モデルそのものを小型化・効率化できれば、必要なGPUや電力、メモリーを減らせる可能性があります。

    つまりAI業界では現在、

    「より多くの計算資源を投入する競争」と「より少ない計算資源で高い性能を出す競争」

    が同時に進んでいます。

    特にQwen3.8-27Bのようなオープンウェイトモデルが高性能化すると、大企業だけでなく、中小企業や個人の開発者でも高性能AIを自分たちの環境で利用できる可能性が広がります。

    ただし、「小さい=必ず安い」とは限りません。

    Artificial AnalysisではQwen3.8-27Bについて、同規模のオープンウェイトモデルと比べるとAPI料金は高めで、回答時に生成するトークン数も多い傾向が確認されています。(Artificial Analysis (https://urldefense.com/v3/__https://artificialanalysis.ai/models/qwen3-8-27b?utm_source=chatgpt.com__;!!J2iG0cdYQnxMGEh0ZjhLAT9Vcpc!Yc1G5A770oiZ1qGG0HI2wX4WVpUzBRzQp4Jx3LYRIQV3xXexTG1WzJh_oO5up0mSlHeEONNkagpEDTy4I2TAs0iEiF6yF9eOeZI$ ))

    モデルの大きさだけでなく、実際の利用コストや速度、必要なハードウェアまで含めて比較することが重要です。

    AI競争は単純な「性能の高さ」だけでなく、性能・コスト・効率のバランスを競う段階へ進みつつあります。

    情報元

    Alibaba Cloud:Qwen3.8-27Bの発表・モデル情報

    Artificial Analysis:Qwen3.8-27B性能評価

    South China Morning Post:Qwen3.8-27Bと大型AIモデルの比較報道

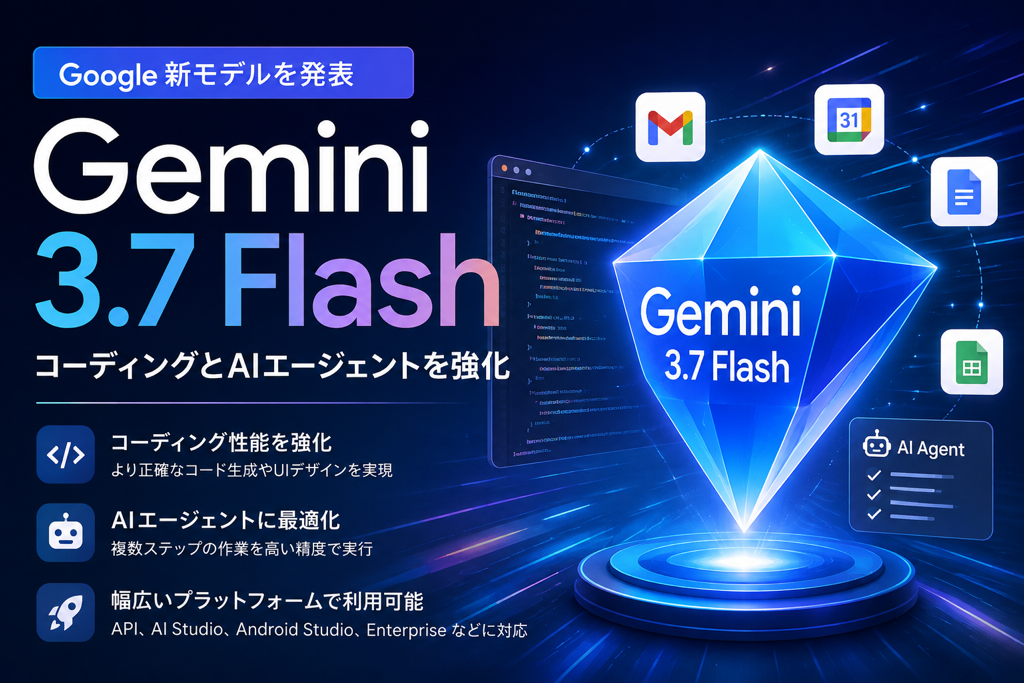
  • Google「Gemini 3.7 Flash」を公開。コーディングとAIエージェントを強化

    Google「Gemini 3.7 Flash」を公開。コーディングとAIエージェントを強化

    Googleは8月13日、新たなAIモデル「Gemini 3.7 Flash」を公開した。前モデル「Gemini 3.6 Flash」の公開から、わずか3週間での投入となる。

    Gemini 3.7 Flashは、Googleが「workhorse(実務を担う主力)」と位置付けるFlashシリーズの最新モデル。ソフトウェア開発やWeb開発、複雑な知識作業などの性能を強化し、特にコーディングやAIエージェントでの利用を重視している。

    Googleによると、コード生成では最初の試行からより正確な結果を出せるようになったほか、UI生成時のデザイン再現性や、指示に忠実に従う能力も改善したという。複数の工程をAIが進めるエージェント用途でも、より高い精度での作業を目指している。

    Gemini 3.7 Flashは、Gemini API、Google AI Studio、Android Studioなど開発者向けサービスのほか、企業向けのGemini Enterpriseにも展開される。

    さらに、Google AI Pro/Ultraユーザー向けのパーソナルAIエージェント「Gemini Spark」にも採用。GmailやGoogleカレンダー、Googleドキュメントなどを利用する複数ステップの作業を、より正確に処理できるようになるとしている。

    Googleは開発者向けに、2026年末まで100万入力トークンあたり0.75ドル、100万出力トークンあたり3.75ドルの導入価格も設定している。2027年1月からは通常価格へ移行する予定だ。

    AI LinkHub解説

    AIは質問に答えるだけでなく、複数の作業を自分で進める「AIエージェント」へと進化しています。

    Gemini 3.7 Flashの登場で、AIに仕事を任せるという使い方がさらに身近になっていきそうです。

    情報元

    Google公式「Introducing Gemini 3.7 Flash」⁠https://blog.google/intl/ja-jp/company-news/technology/gemini-37-flash/

  • GPT-5.6 Solが最大14倍高速に。OpenAIが「Ultrafast」を公開

    GPT-5.6 Solが最大14倍高速に。OpenAIが「Ultrafast」を公開

    2026年8月13日(現地時間)OpenAIは、GPT-5.6 Solを大幅に高速化する新しい処理モード「Ultrafast」をプレビューした。

    Ultrafastでは、GPT-5.6 Solの出力速度をStandard処理と比べて最大14倍まで高速化。出力速度は最大750トークン/秒に達する。

    高速化にはAI半導体を手がけるCerebrasのハードウェアを活用している。モデルそのものの性能だけでなく、AIから回答が返ってくるまでの「速さ」を大きく引き上げる取り組みとなっている。

    まずはAPIを利用する一部の顧客向けに提供し、利用できるキャパシティの拡大に合わせて対象を広げていく計画としている。

    生成AIの性能競争では、これまで回答の精度や推論能力が大きく注目されてきた。今後はそれに加えて、リアルタイム性が求められるAIサービスなどで、「どれだけ速く応答できるか」も重要な競争軸になっていきそうだ。

    AI LinkHub解説

    AIの進化は「どれだけ賢いか」だけでなく、「どれだけ速く反応できるか」にも広がっています。
    人間との会話と変わらないほど瞬時にAIが反応する未来も、少しずつ近づいているのかもしれません。

    情報元

    OpenAI公式|Previewing Ultrafast mode: GPT-5.6 Sol at up to 14X the speed(2026年8月13日)
    https://openai.com/index/previewing-ultrafast/

    Yahoo!ニュース
    https://news.yahoo.co.jp/articles/575f825920f1c2cbbd6946c4fb2dab3b759b40c1